요즘 프론티어 AI 신버전을 보면 기능은 정말 좋아졌습니다. GPT-6 Astra나 얼마 전 공개된 Claude Fable 5.1도 코딩과 컴퓨터 작업을 꽤 오래 이어가는 쪽을 내세우고 있습니다. 이런 모델을 보면 당연히 에이전트에 연결해서 써보고 싶어집니다.
그런데 막상 오래 돌리는 상황을 생각하면 비용이 먼저 신경 쓰입니다. 에이전트는 질문 한 번에 답하고 끝나는 게 아니기 때문입니다. 저장소를 읽고, 파일을 찾고, 도구를 실행하고, 결과가 이상하면 다시 돌아갑니다. 일을 하나 끝내는 동안 모델을 계속 부르게 되죠.
GPT-6 Astra의 표준 API 가격은 100만 토큰당 입력 10달러, 출력 50달러입니다. 입력이 272K를 넘으면 해당 요청의 입력·캐시 가격은 2배, 출력은 1.5배로 올라가고 검색이나 컴퓨터 사용 같은 도구에는 별도 비용이 붙을 수 있습니다(OpenAI 가격 문서). Claude Fable 5.1도 기본 단가는 입력 10달러, 출력 50달러입니다. 대신 캐시 읽기는 0.25달러까지 낮췄고, Anthropic은 같은 내용을 반복해서 읽는 agentic 작업이라면 비용을 줄일 수 있다고 설명합니다(Anthropic 발표).
두 모델의 가격과 작업별 차이는 이전 비교 글에서 따로 정리했습니다. 이번에는 그 비용을 계속 지불하지 않고도 반복 작업을 이어갈 수 있는지가 더 궁금했습니다.
한두 번 물어볼 때는 괜찮습니다. 하지만 에이전트를 몇 시간씩 돌리기 시작하면 이야기가 달라집니다. 가장 어려운 판단을 할 때는 좋은 모델을 쓰더라도, 파일을 찾고 테스트를 다시 돌리는 중간 과정까지 계속 같은 가격을 내야 할까 싶었습니다.
그래서 평이 좋았던 Qwen3.6-35B-A3B를 로컬에서 사용해봤습니다. 그런데 도구 호출과 반복 작업을 붙이자 오류가 계속 났습니다. 짧게 답변을 받는 것과 달리, 도구 결과를 받아 다음 작업으로 넘어가고 다시 호출하는 과정을 오래 이어가는 데에는 한계가 분명했습니다.
그러던 중 Occamy-1.0이라는 모델이 나왔습니다. 완전히 새로운 기반 모델은 아니고, 제가 사용했던 Qwen3.6-35B-A3B에 에이전트 작업을 위한 후속 학습을 더한 모델입니다.
제가 Qwen에서 아쉬웠던 부분을 그대로 손본 셈입니다.
Qwen에서 막혔던 부분을 손본 모델입니다
일반적인 답변 한 번보다 에이전트 작업은 훨씬 복잡합니다. 필요한 도구를 고르고, 함수 인자를 만들고, 실행 결과를 다시 읽은 뒤 다음 행동을 정해야 합니다. 이 과정을 여러 번 반복하면서 앞에서 하던 일도 기억해야 하고요.
Occamy는 이런 co-work 작업을 이어가는 방향으로 후속 학습됐습니다. 도구를 한 번 호출하는 데서 끝나는 것이 아니라, 실행 결과를 받고 다시 판단하는 긴 작업을 다룹니다. 공개된 벤치마크에서도 기반 Qwen보다 에이전트 평가가 크게 오른 부분이 보입니다.
그래서 적어도 학습 방향과 제작팀이 공개한 결과만 보면, 제가 기존 Qwen에서 막혔던 부분을 정면으로 고친 모델로 보입니다. 실제 로컬 환경에서도 오류가 줄었는지는 직접 돌려봐야겠지만, 이번에는 확인해볼 이유가 분명했습니다.
반복 작업에서는 어떤 숫자를 봐야 할까
제가 Qwen을 쓰면서 겪은 문제는 도구를 전혀 부르지 못한다는 것이 아니었습니다. 첫 번째 호출은 되는데 결과를 받은 다음 엉뚱한 도구를 고르거나, 같은 행동을 반복하거나, 작업이 길어질수록 처음 목표에서 벗어나는 경우가 더 문제였습니다.
그래서 이런 모델은 함수 호출 벤치마크 하나만 봐서는 부족합니다. 어떤 도구를 고르고 인자를 맞추는지 보는 BFCL, 도구 실행을 포함한 작업을 한 번에 끝냈는지 보는 AutomationBench Pass¹, 여러 턴의 사용자와 도구 상태를 이어가는 τ³-Bench, 열린 작업을 오래 진행하는 WildClawBench, 실제 터미널 코딩을 끝내는 Terminal-Bench를 함께 봐야 합니다.
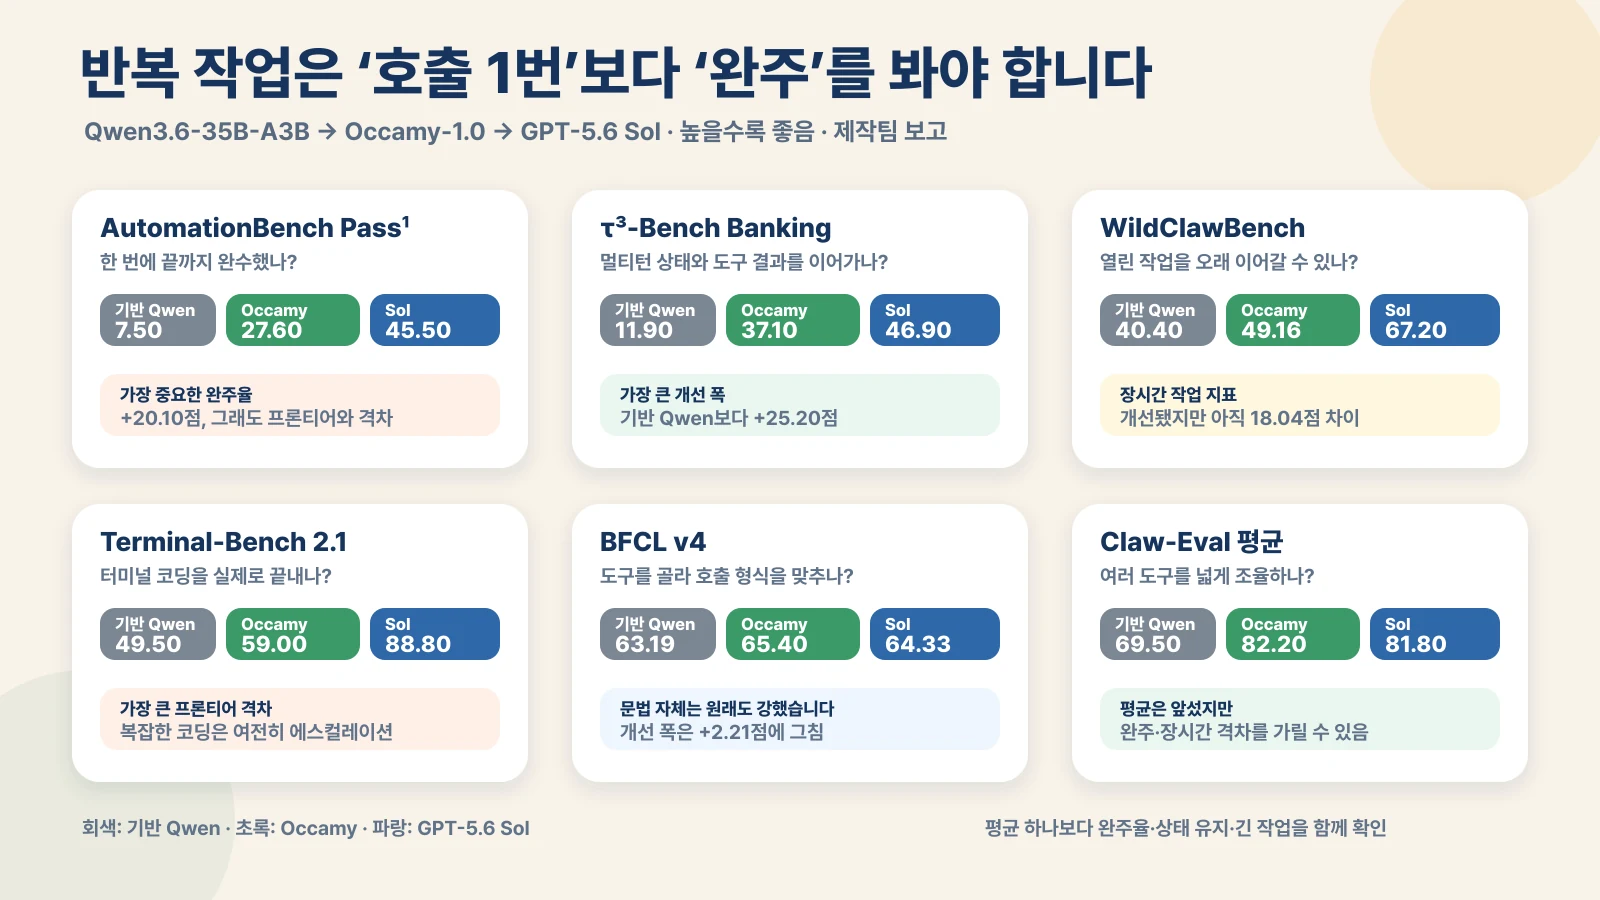
숫자를 이렇게 나눠보면 Occamy가 무엇을 손봤는지도 보입니다. 도구 선택과 호출 형식을 보는 BFCL v4는 기반 Qwen의 63.19에서 65.40으로 2.21점 올랐습니다. 반면 AutomationBench Pass¹은 7.50에서 27.60으로, τ³-Banking은 11.90에서 37.10으로 올랐습니다.
즉 Occamy의 변화는 “함수를 호출할 줄 아느냐”보다 “호출한 뒤 결과를 받고 다음 단계로 넘어가며 끝까지 이어갈 수 있느냐”에 더 가깝습니다. 제가 기존 Qwen에서 아쉬웠던 부분도 바로 이쪽이었습니다.
Occamy 이전에도 로컬 에이전트 모델은 있었습니다
Occamy가 아무것도 없던 자리에서 갑자기 나온 것은 아닙니다. Qwen 계열을 바탕으로 장기 탐색이나 코딩, 도구 호출에 맞춰 후속 학습한 모델들이 이미 여럿 나왔습니다. Occamy 보고서가 같은 표에서 비교한 대표 모델을 추리면 이렇습니다.
| 모델 | 주로 노린 작업 | Claw-Eval 평균 | Automation Pass¹ | Terminal-Bench | 같은 표에서 보이는 한계 |
|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | 범용 기반 모델 | 69.50 | 7.50 | 49.50 | 일반 성능과 함수 호출은 괜찮지만 완전 자동화 성공률이 낮음 |
| Agents-A1 | 장기 탐색·공학·과학 에이전트 | 69.90 | 2.20 | 41.60 | 탐색 지향이지만 이 평가의 완주 수치는 낮음 |
| Nex-N2-mini | 로컬 에이전트·터미널 작업 | 66.60 | 5.70 | 60.70* | 터미널 점수는 높지만 co-work 평균과 완주율이 낮음 |
| Ornith-1.5 | 도구 호출·코딩 에이전트 | 64.40 | 18.50 | 67.80* | 코딩 쪽은 강하지만 넓은 co-work 평균은 낮음 |
| Occamy-1.0 | 장시간 co-work 후속 학습 | 82.20 | 27.60 | 59.00 | 로컬 비교군 중 완주율은 가장 높지만 터미널은 최고가 아님 |
여기서 중요한 것은 모델마다 잘하는 일이 다르다는 점입니다. Nex-N2-mini와 Ornith-1.5는 Terminal-Bench에서 Occamy보다 높습니다. Occamy가 돋보이는 부분은 특정 코딩 벤치 하나가 아니라 Claw-Eval 평균과 AutomationBench 완주율을 함께 끌어올렸다는 데 있습니다.
다만 별표가 붙은 Terminal-Bench 점수는 Occamy 보고서가 각 모델 카드와 외부 평가의 값을 인용한 것입니다. 완전히 같은 환경에서 다시 돌린 수치가 아니므로 순위를 확정하는 용도로 쓰기는 어렵습니다.
마침 이런 모델을 올려볼 하드웨어 조건도 조금씩 달라지고 있습니다.
Mac Studio의 메모리도 꽤 커졌습니다
Apple은 2026년 8월 25일 새 Mac Studio를 발표했습니다. M5 Max는 최대 128GB, M5 Ultra는 최대 512GB 통합 메모리를 지원합니다. M5 Ultra의 메모리 대역폭은 1.2TB/s입니다(Apple 발표, 제품 사양).
이 글을 정리하는 9월 20일에는 아직 사전 주문 단계입니다. 정식 판매는 9월 22일부터라 실제 사용기도 충분히 나오지 않았습니다. Apple이 발표한 성능 수치만 보고 특정 AI 모델의 속도를 예상하기도 어렵고요.
그래도 개인용 컴퓨터 한 대에 수십 GB, 많게는 수백 GB짜리 오픈웨이트 모델을 올릴 수 있다는 점은 눈에 들어옵니다. 예전에는 서버에서나 생각했던 크기의 모델을 책상 위에 두고 돌려볼 수 있게 된 셈입니다. Occamy처럼 전체 크기가 35B인 모델도 이제는 Mac에서 직접 확인해볼 수 있는 범위로 들어오고 있습니다.
Reddit의 초기 반응도 좋은 편이었습니다
r/LocalLLaMA에 Occamy-1.0을 소개하는 글이 올라온 것은 9월 15일입니다. 제가 확인했을 때 약 97개의 추천을 받고 있었습니다(Reddit 스레드). 앞에서 말한 후속 학습이 실제 사용에서도 차이를 만드는지 궁금해서 반응을 조금 더 살펴봤습니다.
원 게시자는 Qwen3.8 27B와 Ornith 1.5 대신 Occamy를 사용하고 있다고 했습니다. RTX 5060 Ti 두 장에서 127K 컨텍스트로 약 28GB VRAM을 썼고, 초당 80~90토큰의 디코드 속도를 봤다는 내용이었습니다. Q4_K_M을 받아본 사람들의 첫 반응도 좋은 편이었습니다.
이 정도면 로컬에서 돌리기 꽤 괜찮은 모델처럼 보입니다. 다만 같은 스레드를 더 읽어보면 아직 확인해야 할 부분도 나옵니다. 다른 quant의 디스크 용량을 잘못 읽은 사례가 있었고, 긴 컨텍스트를 압축하면서 계속 작업해도 안정적인지 묻는 의견도 있었습니다. Occamy 기여자도 재현할 수 있는 실패 사례를 공유해달라고 요청했습니다.
Reddit 반응만으로 성능을 판단하기는 어렵지만, 왜 속도가 빠르다는 이야기가 나오는지는 모델 구조를 보면 이해할 수 있습니다.
35B 모델인데 계산에는 약 3B가 참여합니다
Occamy-1.0은 Accio Team이 공개한 모델입니다. 논문과 공식 모델 카드에는 팀 이름만 적혀 있고 소속은 직접 나오지 않습니다. 핵심 기여자의 공개 LinkedIn 글과 언론 보도에서는 Alibaba Group 산하 Accio 조직으로 소개됩니다.
기반 모델은 Qwen3.6-35B-A3B입니다. 전체 파라미터는 35B지만 토큰 하나를 처리할 때 약 3B가 계산에 참여하는 MoE(Mixture of Experts) 구조입니다. 40개 레이어와 256개 expert를 두고, 그중 routed expert 8개와 shared expert 1개를 사용합니다. 최대 컨텍스트는 262,144토큰이고, 긴 작업을 위한 SFT에는 131,072토큰 길이가 쓰였습니다. 라이선스는 Apache-2.0입니다(공식 모델 카드, 기술 보고서).
토큰마다 35B 전체를 계산하는 dense 모델보다 연산 부담이 작으니 속도는 기대해볼 만합니다. 여기서 주의할 점은 메모리입니다. 다음 토큰에서 어떤 expert를 쓸지 미리 알 수 없기 때문에 전체 35B 가중치는 메모리에 올려야 합니다.
그러니까 활성 3B는 계산량에 가까운 숫자입니다. 3B짜리 작은 모델처럼 몇 GB 메모리로 돌아간다는 뜻은 아닙니다.
Mac에서는 메모리가 얼마나 필요할까
공식 GGUF 파일을 보면 Q4_K_M은 21.167GB, Q8_0은 36.903GB입니다. F16 비전 projector를 Q4에 더하면 22GB가 조금 넘습니다. Apple Silicon용으로 변환한 커뮤니티 MLX 6-bit 빌드는 총 29.9GB입니다.
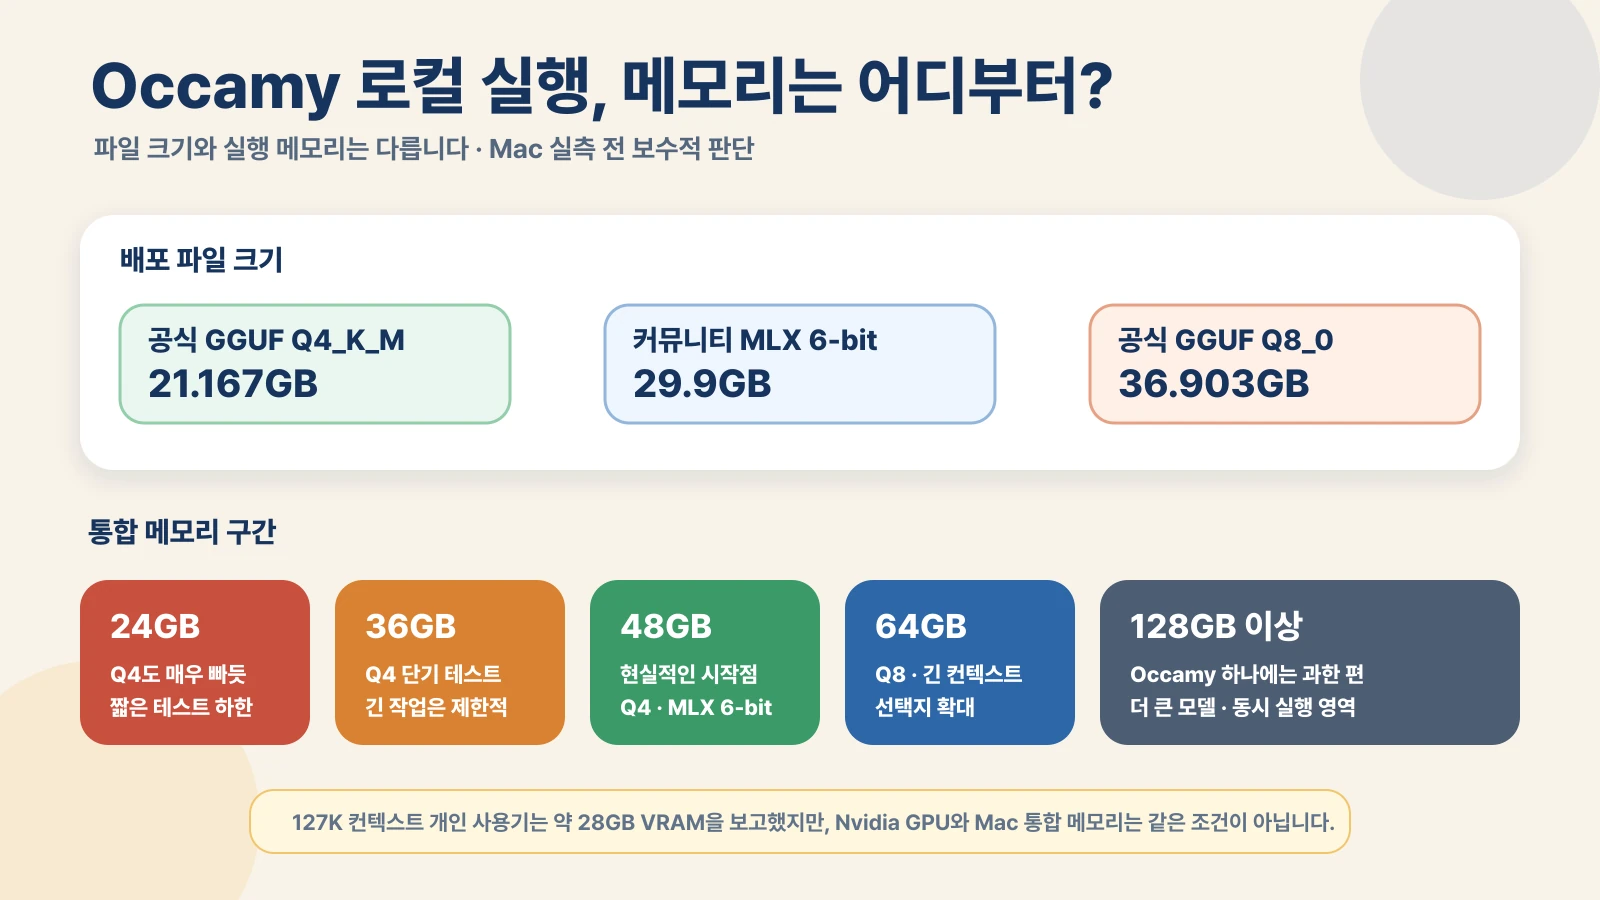
파일 크기만 보면 Q4는 24GB Mac에도 들어갈 것처럼 보입니다. 그런데 실행할 때는 모델만 메모리를 쓰는 게 아닙니다. macOS와 다른 앱이 먼저 메모리를 쓰고 있고, 런타임 버퍼와 KV cache도 필요합니다. 공식 GGUF 문서에도 파일 크기와 실제 RAM·VRAM 요구량은 다르다고 적혀 있습니다.
아직 Mac에서 직접 돌린 결과가 없다는 조건을 붙이면, 대략 이렇게 볼 수 있습니다.
- 24GB: Q4를 짧은 컨텍스트로 시험해볼 수 있는 하한선에 가깝습니다.
- 36GB: Q4 텍스트 테스트는 가능하겠지만 긴 에이전트 작업에는 빠듯할 수 있습니다.
- 48GB: Q4나 커뮤니티 MLX 6-bit를 확인해볼 현실적인 시작점입니다.
- 64GB: Q8이나 더 긴 컨텍스트까지 시도할 여유가 생깁니다.
- 128GB 이상: Occamy 하나만 돌리기에는 많지만, 더 큰 모델이나 여러 모델을 함께 띄울 때는 유리합니다.
최대 컨텍스트가 262K라고 해도 그 길이를 부담 없이 쓸 수 있는 것은 아닙니다. 대화와 작업 기록이 길어질수록 KV cache가 커지고 입력을 처리하는 시간도 늘어납니다.
앞서 Reddit 사용자는 127K 컨텍스트에서 약 28GB VRAM을 썼다고 했습니다. Nvidia GPU 두 장과 Mac 통합 메모리는 조건이 다르지만, Q4 파일이 21GB라는 이유만으로 24GB 기기가 충분하다고 말하기 어려운 이유는 보여줍니다.
메모리는 어느 정도 감이 왔습니다. 이제 정말 에이전트 작업을 잘하는 모델인지 숫자를 살펴볼 차례입니다.
기존 로컬 강자보다 낫지만, 프론티어 모델은 아닙니다
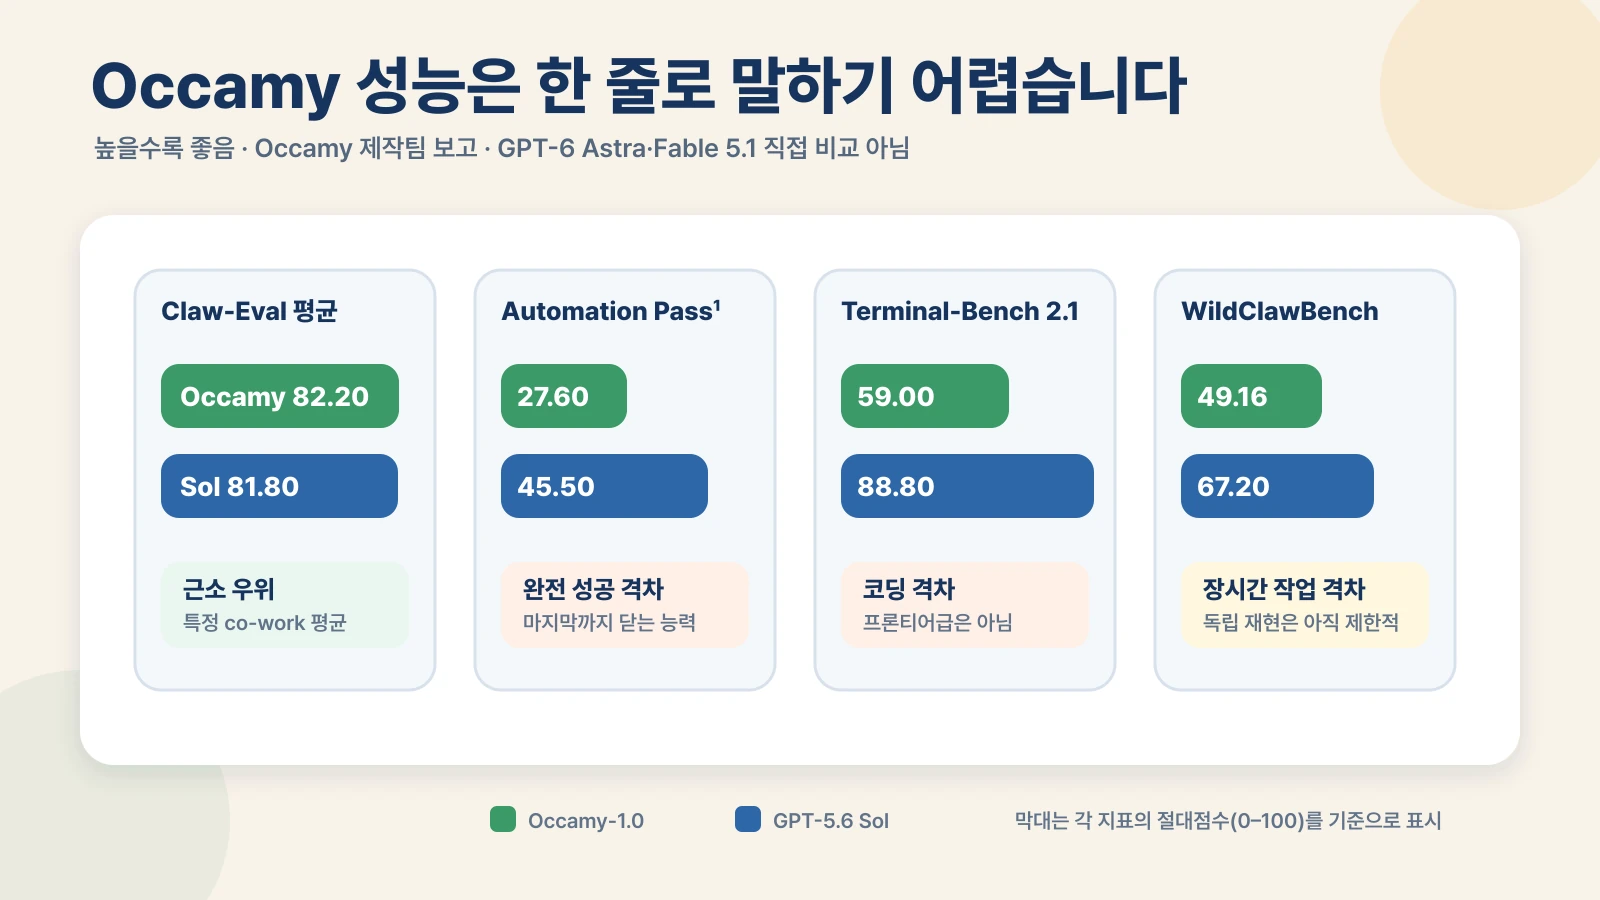
먼저 기반 모델과 비교하면 변화가 꽤 큽니다. 제작팀 보고에서 Claw-Eval 평균은 Qwen3.6-35B-A3B의 69.5에서 82.2로 올랐습니다. AutomationBench Pass¹은 7.5에서 27.6, Terminal-Bench는 49.5에서 59.0이 됐습니다(기술 보고서). 같은 크기의 기반 모델을 그대로 쓰는 것보다 에이전트 작업에 맞춘 후속 학습이 효과를 낸 것으로 보입니다.
눈에 띄는 숫자는 Claw-Eval 평균입니다. Occamy가 82.20으로 GPT-5.6 Sol의 81.80을 조금 앞섭니다. 이 숫자만 보면 작은 활성 파라미터로 프론티어 모델을 따라잡은 것처럼 보입니다.
그런데 작업을 끝까지 성공해야 하는 항목에서는 차이가 납니다. AutomationBench Pass¹은 Occamy 27.60, GPT-5.6 Sol 45.50입니다. Terminal-Bench는 59.00과 88.80이고, 개방형 장시간 작업을 보는 WildClawBench도 49.16과 67.20으로 벌어집니다. 멀티턴 상태 유지에 가까운 τ³-Banking도 37.10과 46.90입니다.
여러 도구를 오가며 중간 과정을 진행하는 능력은 좋아졌지만, 마지막까지 작업을 끝내는 능력과 복잡한 터미널 코딩은 아직 차이가 있다고 볼 수 있습니다. 특히 Terminal-Bench는 29.8점 차이라서 어려운 디버깅과 대규모 코드 변경까지 로컬 모델 하나에 맡기기는 이릅니다. 이 표에는 GPT-6 Astra나 Claude Fable 5.1을 같은 조건으로 비교한 수치도 없습니다.
또 하나 봐야 할 것은 이 결과가 대부분 제작팀의 자체 보고라는 점입니다. 외부 결과로는 DGX Spark GB10과 llama.cpp에서 69개 시나리오를 돌린 평가가 있습니다. Q4_K_M이 87/100을 받았지만 실제 채점은 65/69였고, 문법 오류 4건은 제외됐습니다. Apple Silicon에서 돌린 결과도 아닙니다(외부 tool-eval).
벤치마크만 보면 기대되는 부분은 있습니다. 다만 제가 로컬 에이전트에서 더 궁금한 것은 다른 쪽입니다.
모델을 받는 것보다 하네스를 맞추는 일이 남습니다
로컬 모델로 답변 한 번을 받는 것과 에이전트가 일을 끝까지 하는 것은 꽤 다릅니다. 함수를 제대로 골라도 JSON 인자가 깨질 수 있고, 도구 결과를 받은 뒤 같은 호출을 반복할 수도 있습니다. 대화가 길어지면서 앞에서 하던 일을 잊기도 합니다.
Occamy의 공식 참조 설정은 SGLang과 vLLM에서 qwen3 reasoning parser와 qwen3_coder tool-call parser를 사용합니다. 모델 출력에서 함수 이름과 JSON 인자를 꺼내기 위한 설정입니다. thinking을 켜고, 여러 턴을 이어갈 때 assistant의 reasoning과 tool call을 그대로 보존하라는 요구도 있습니다. 다음 턴에서 앞선 판단과 도구 상태를 이어가기 위해서입니다.
공개된 Dressage 학습 스택에도 실행 가능한 태스크 계약, multi-harness, token-exact trajectory, 상태 재생 같은 기능이 들어 있습니다. 처음부터 긴 에이전트 작업을 염두에 두고 학습한 모델이라는 점은 흥미롭습니다.
하지만 같은 GGUF를 Ollama나 LM Studio에 올렸을 때도 공식 설정과 같은 방식으로 tool call이 오가는지는 직접 확인해야 합니다. chat template이나 parser가 달라지면 결과도 달라질 수 있으니까요.
결국 확인하고 싶은 것은 벤치마크 한 줄보다 실제 작업입니다. tool call을 몇 번까지 깨지지 않고 이어가는지, 컨텍스트를 줄인 뒤에도 하던 일을 기억하는지, 코딩 작업을 시작만 하는 게 아니라 끝까지 마치는지를 봐야 합니다.
고사양 Mac에서는 MLX 6-bit부터 확인해보려고 합니다
제가 가진 것처럼 통합 메모리가 넉넉한 Mac이라면 우선 29.9GB짜리 Occamy MLX 6-bit 변환본부터 시작하는 편이 간단합니다. 공식 체크포인트가 아니라 커뮤니티 변환본이라는 점은 감안해야 하지만, Apple Silicon에서 바로 쓸 수 있고 비전 입력도 포함돼 있습니다.
먼저 MLX LM을 설치하고 로컬 서버를 띄웁니다.
uv tool install mlx-lm
mlx_lm.server --model "leonsarmiento/Occamy-1.0-6bit-XL-mlx"
기본 서버는 Mac 내부의 루프백 인터페이스와 8080번 포트에서 열립니다. OpenAI 호환 API를 지원하므로 OpenClaw나 Hermes 같은 에이전트의 custom provider를 이 엔드포인트로 연결하면 됩니다. MLX 공식 문서도 이 서버를 로컬 HTTP 엔드포인트로 설명하며, 보안 검사가 제한적이므로 운영 서버로 공개하지 말라고 안내합니다(MLX LM 서버 문서). Mac 안에서만 쓰고 LAN이나 인터넷에 포트를 열지 않는 편이 좋습니다.
Occamy 제작팀의 권장 생성값은 temperature 1.0, top_p 0.95, top_k 20, presence_penalty 1.5, 최대 출력 32,768토큰입니다. 다만 이 값을 넣고 대화가 잘 된다고 끝내면 제가 궁금했던 부분을 확인할 수 없습니다. 실제로는 다음 순서로 테스트해보는 편이 낫습니다.
- 파일 읽기처럼 단순한 도구 하나를 20회 반복해 JSON 인자와
tool_calls필드가 깨지지 않는지 봅니다. - 검색 → 파일 수정 → 테스트 → 오류 수정처럼 도구가 바뀌는 작업을 20~50턴 이어갑니다.
- 일부러 도구 오류를 한 번 넣고, 같은 호출을 무한 반복하지 않고 복구하는지 확인합니다.
- 컨텍스트가 길어진 뒤 요약하거나 줄였을 때 원래 목표와 완료 조건을 유지하는지 봅니다.
- 성공 여부와 함께 초당 토큰 수, 최대 메모리, 첫 토큰 대기시간을 기록합니다.
여기서 기록할 숫자는 단순 호출 성공률, 올바른 도구 선택률, JSON 파싱 성공률, 오류 복구율, 그리고 최종 완주율입니다. 모델 카드에는 qwen3 reasoning parser와 qwen3_coder tool-call parser가 권장돼 있지만, MLX와 연결한 에이전트가 같은 형식으로 해석하는지는 별도 확인이 필요합니다. 응답의 tool_calls가 비어 있고 본문에 <tool_call> 같은 문자열이 그대로 남는다면 모델 자체보다 런타임 파서 문제일 가능성도 있습니다.
64GB Mac에서는 6-bit 모델을 올리고 중간 길이 컨텍스트부터 시작해볼 수 있습니다. 128GB 이상이라면 모델 가중치 자체는 충분히 들어가므로 32K, 64K, 128K 순서로 컨텍스트를 늘리며 KV cache와 속도를 확인하는 편이 안전합니다. 최대 262K를 처음부터 잡는 것보다 실제 반복 작업이 안정적으로 완주되는 구간을 찾는 것이 더 중요합니다.
일단 나눠서 맡겨보는 쪽이 현실적입니다
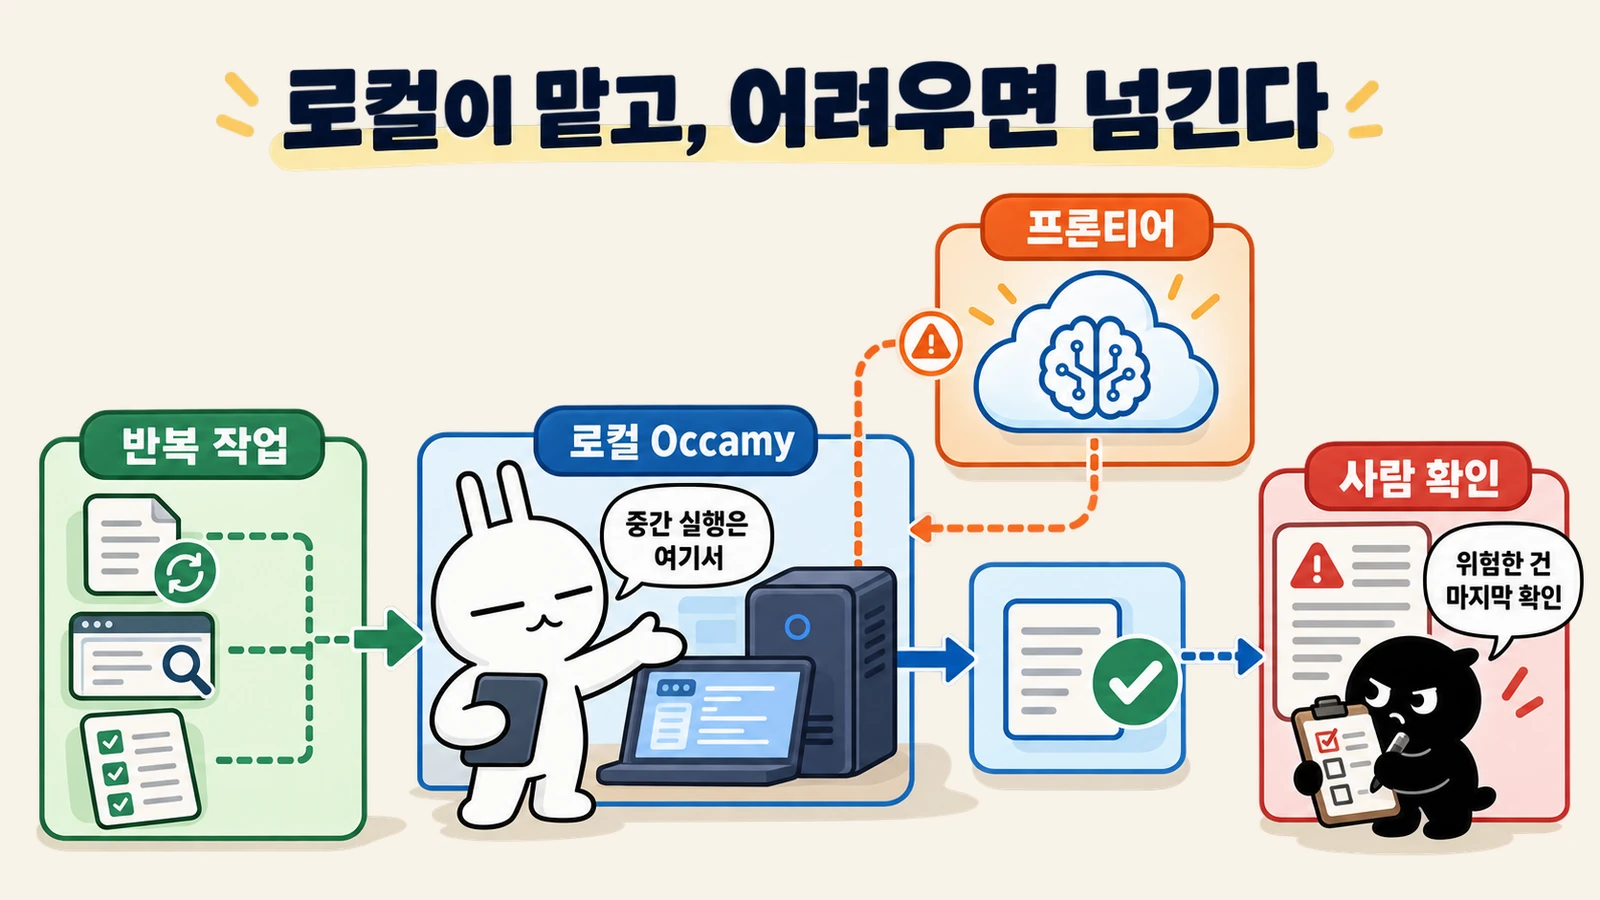
Occamy가 GPT-6 Astra나 Claude Fable 5.1을 그대로 대신할 수 있다고 보기는 어렵습니다. 완전 성공률과 터미널 작업에서는 아직 차이가 있고, Q4 파일도 21GB가 넘습니다.
그래도 저장소를 살펴보고 파일을 정리하거나, 정해진 도구와 테스트를 반복하는 일에는 먼저 써볼 수 있을 것 같습니다. 사람이 바로 확인할 수 있는 작은 코드 변경도 후보가 될 수 있고요. 여기서 계속 막히는 복잡한 설계나 디버깅은 프론티어 모델로 넘기면 됩니다.
결제·삭제·권한 변경·외부 전송처럼 되돌리기 어려운 동작은 어느 모델을 쓰든 사람이 마지막에 확인해야 합니다.
이번에 공개된 자료를 살펴보면서 Occamy가 모든 일을 해결해줄 모델이라는 생각은 들지 않았습니다. 대신 프론티어 모델을 매번 부르지 않고도 에이전트의 중간 작업을 이어갈 수 있을지 시험해볼 만한 후보는 된 것 같습니다.
이제 Mac에서 직접 돌렸을 때 속도가 얼마나 나오는지, 긴 컨텍스트에서 메모리가 얼마나 남는지, tool call이 몇 번이나 제대로 왕복하는지를 확인해봐야겠습니다. 공개된 벤치마크보다 이 결과가 더 궁금합니다.