Gemini 4 Argon이 발표 13일 만인 10월 13일(미국 날짜 기준)에 유료 사용자에게 열렸습니다. 9월 30일에는 보안 방어 파트너와 일부 테스터만 쓸 수 있던 모델인데요. 이번에 Gemini 앱에서는 Pro 구독자까지 쓸 수 있게 됐습니다.
그런데 열렸다는 소식만으로는 내 계정에서 되는지 알기 어렵죠. Pro라도 Antigravity에서는 막혀 있고, API는 구독과 따로 결제해야 하거든요. 이미 Claude나 ChatGPT를 쓰고 있다면 굳이 이걸 또 써야 하는지도 궁금할 테고요. 그래서 누가 어디서 얼마에 쓸 수 있는지, 성능 근거는 어디까지 확인됐는지, Claude Opus 5.5·GPT-6 Astra와 견주면 어디에 쓸 만한지를 차례로 정리해 봤습니다.
저는 Argon을 직접 써 보지 않았고, Google의 공식 글과 문서, 독립 평가 사이트 Artificial Analysis(AA)와 Vals AI, 경쟁사 가격표, Hacker News 스레드를 10월 14일 오후 4시쯤(한국 시간)까지 열어 본 내용으로 썼습니다. 요금제 조건과 가격은 금방 바뀔 수 있어서 날짜를 같이 적어 둡니다.
요금제마다 열린 곳이 다릅니다
Google의 공개 확대 글부터 보면, 일반 사용자는 AI Pro·Ultra 구독자라면 Gemini 앱과 검색 AI 모드에서, 개발자는 API 유료 티어에서 쓸 수 있고 Antigravity와 AI Studio는 Ultra 구독자만 씁니다.
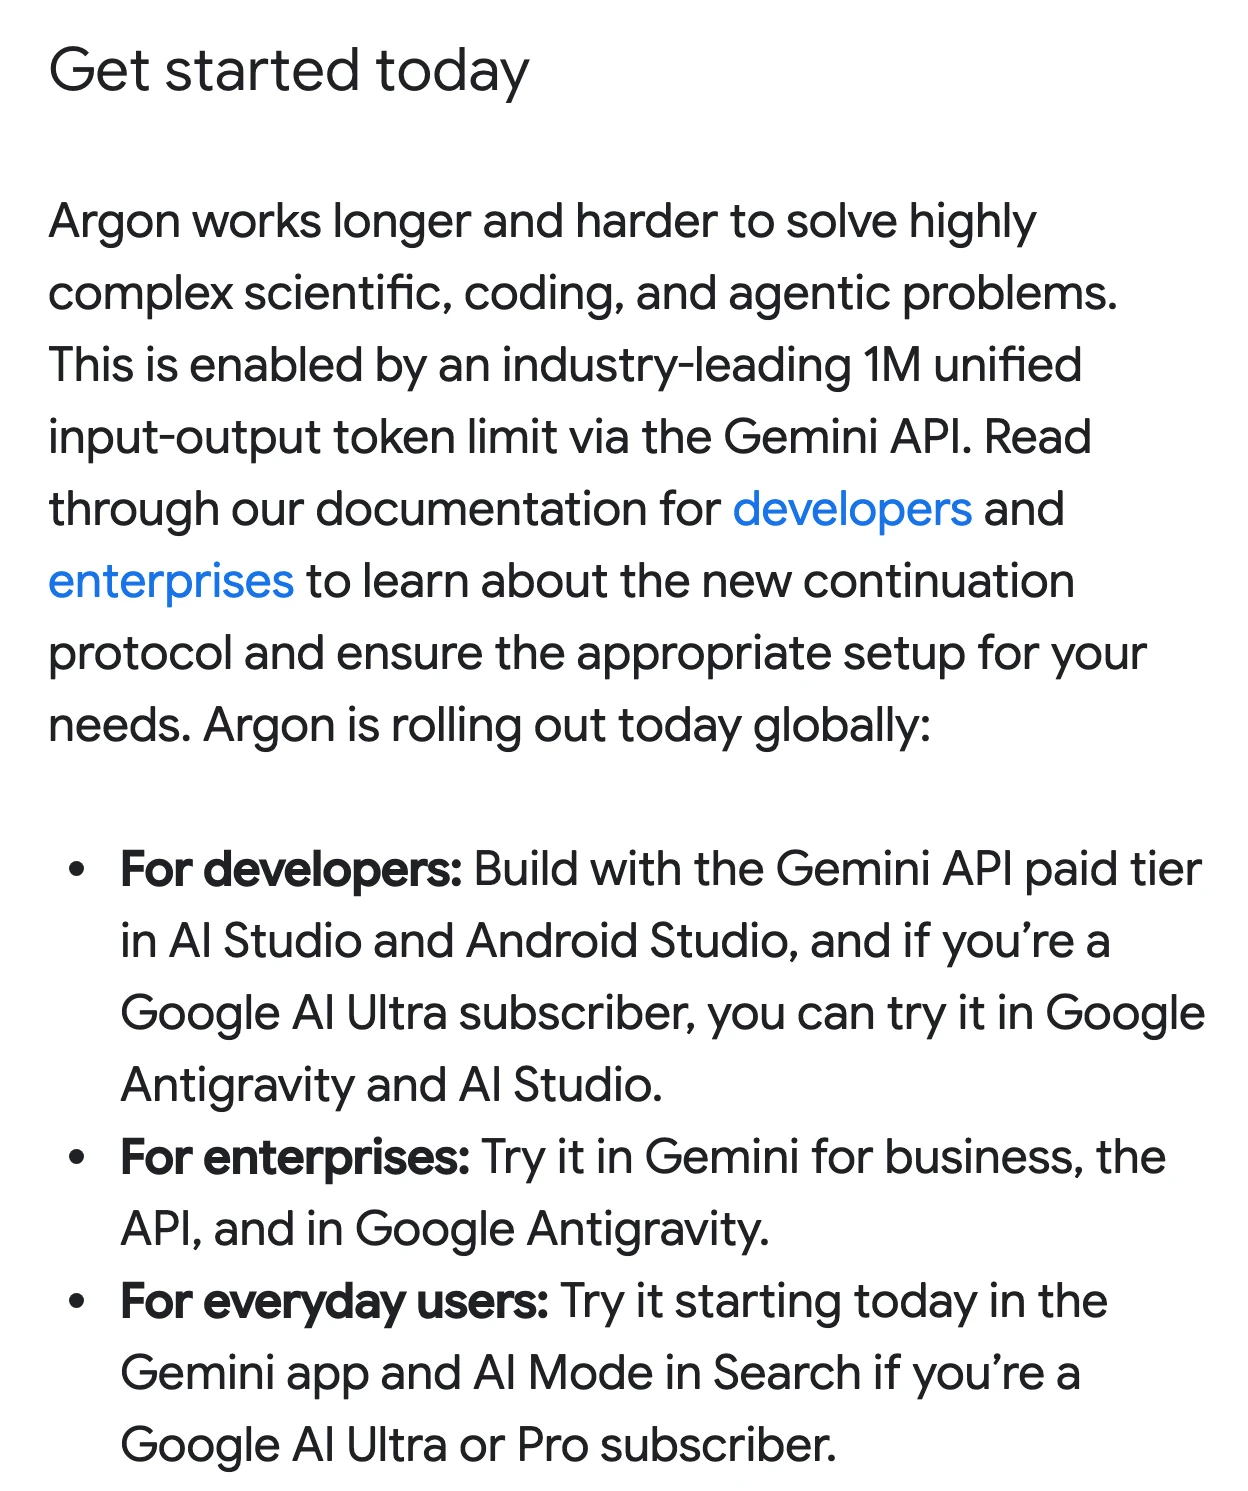
이 글 하나로는 Pro와 Ultra가 갈리는 곳이 한눈에 안 들어와서, Gemini 앱 공지와 Antigravity 모델 문서, API 가격 문서까지 합쳐 표로 만들어 봤습니다.
| 경로 | AI Pro | AI Ultra |
|---|---|---|
| Gemini 앱·AI 모드 | 가능 | 가능 |
| Antigravity | 불가 | 가능 |
| Antigravity의 Opus 5.5 | 정식만 | 가능 |
| AI Studio | 불가 | 가능 |
| Gemini API | 별도 | 별도 |
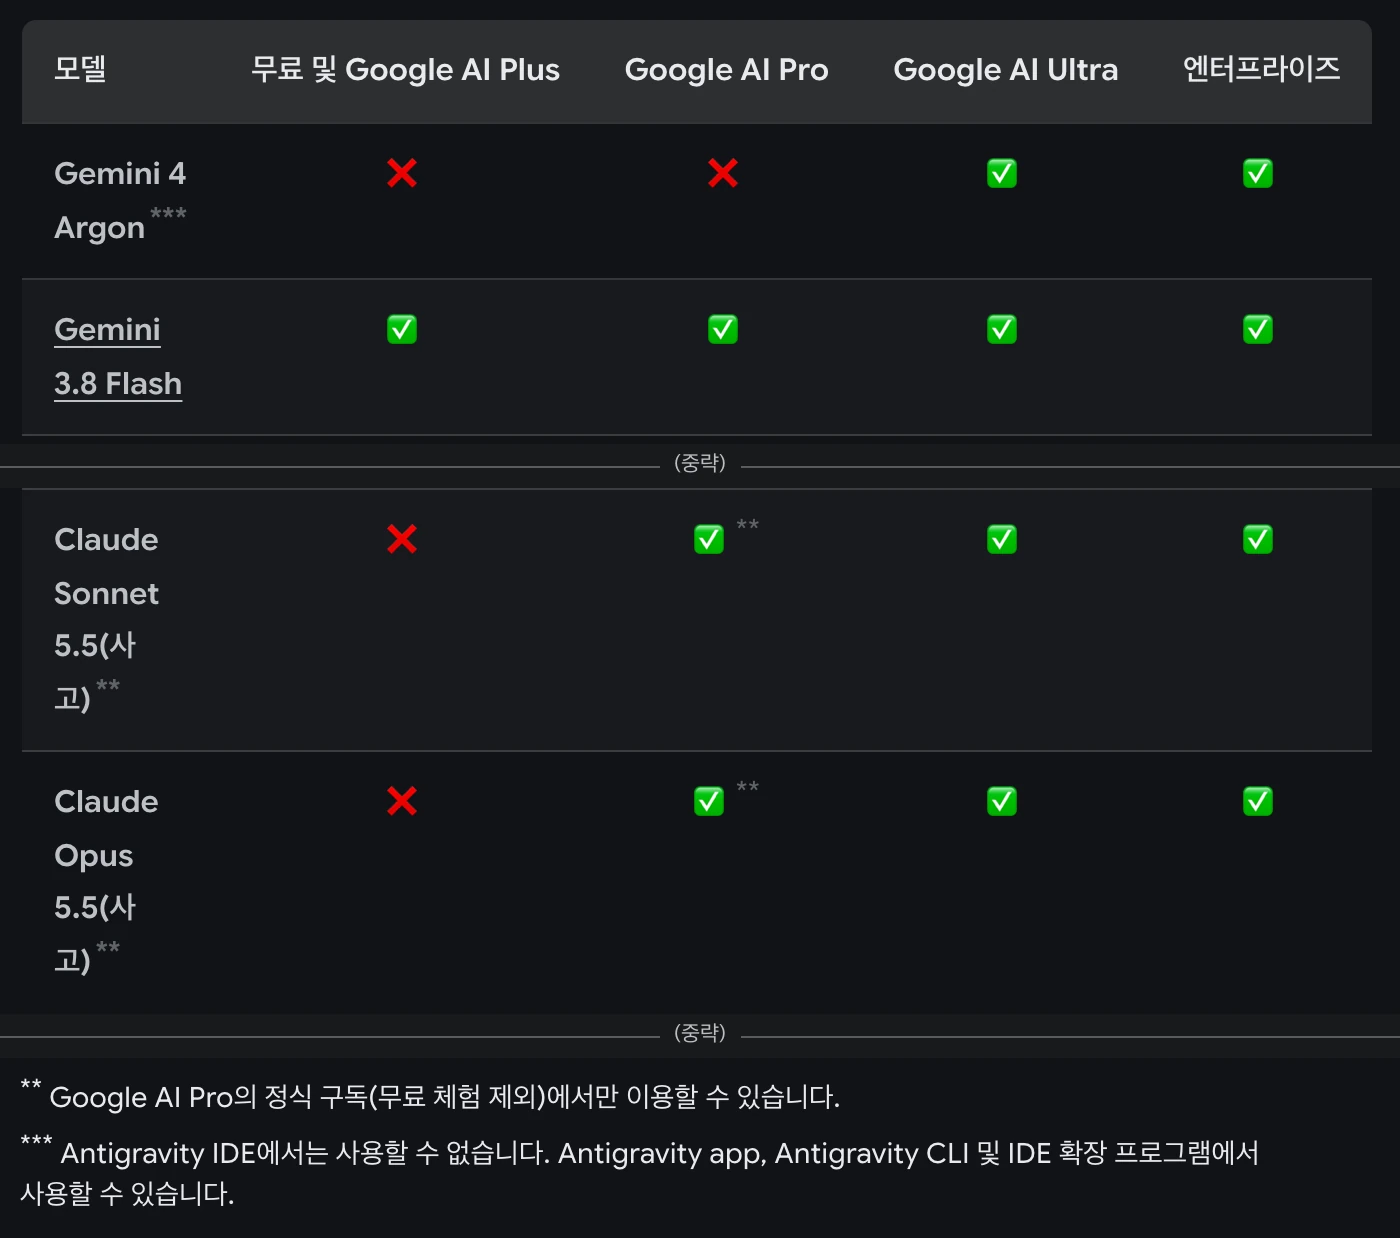
'정식만'은 무료 체험을 뺀 정식 구독이라는 뜻이고, API의 '별도'는 구독과 따로 유료 티어를 열어야 한다는 뜻입니다. 눈여겨볼 곳은 Antigravity 줄인데요. 문서의 요금제별 표를 보면 Argon은 무료·Plus·Pro가 ❌, Ultra와 Enterprise가 ✅입니다. Pro에서는 대신 Claude Opus 5.5·Sonnet 5.5와 Gemini 3.8 Flash를 고르게 되니, Google 도구 안에서 Google의 새 모델 대신 Claude를 쓰는 셈이죠.
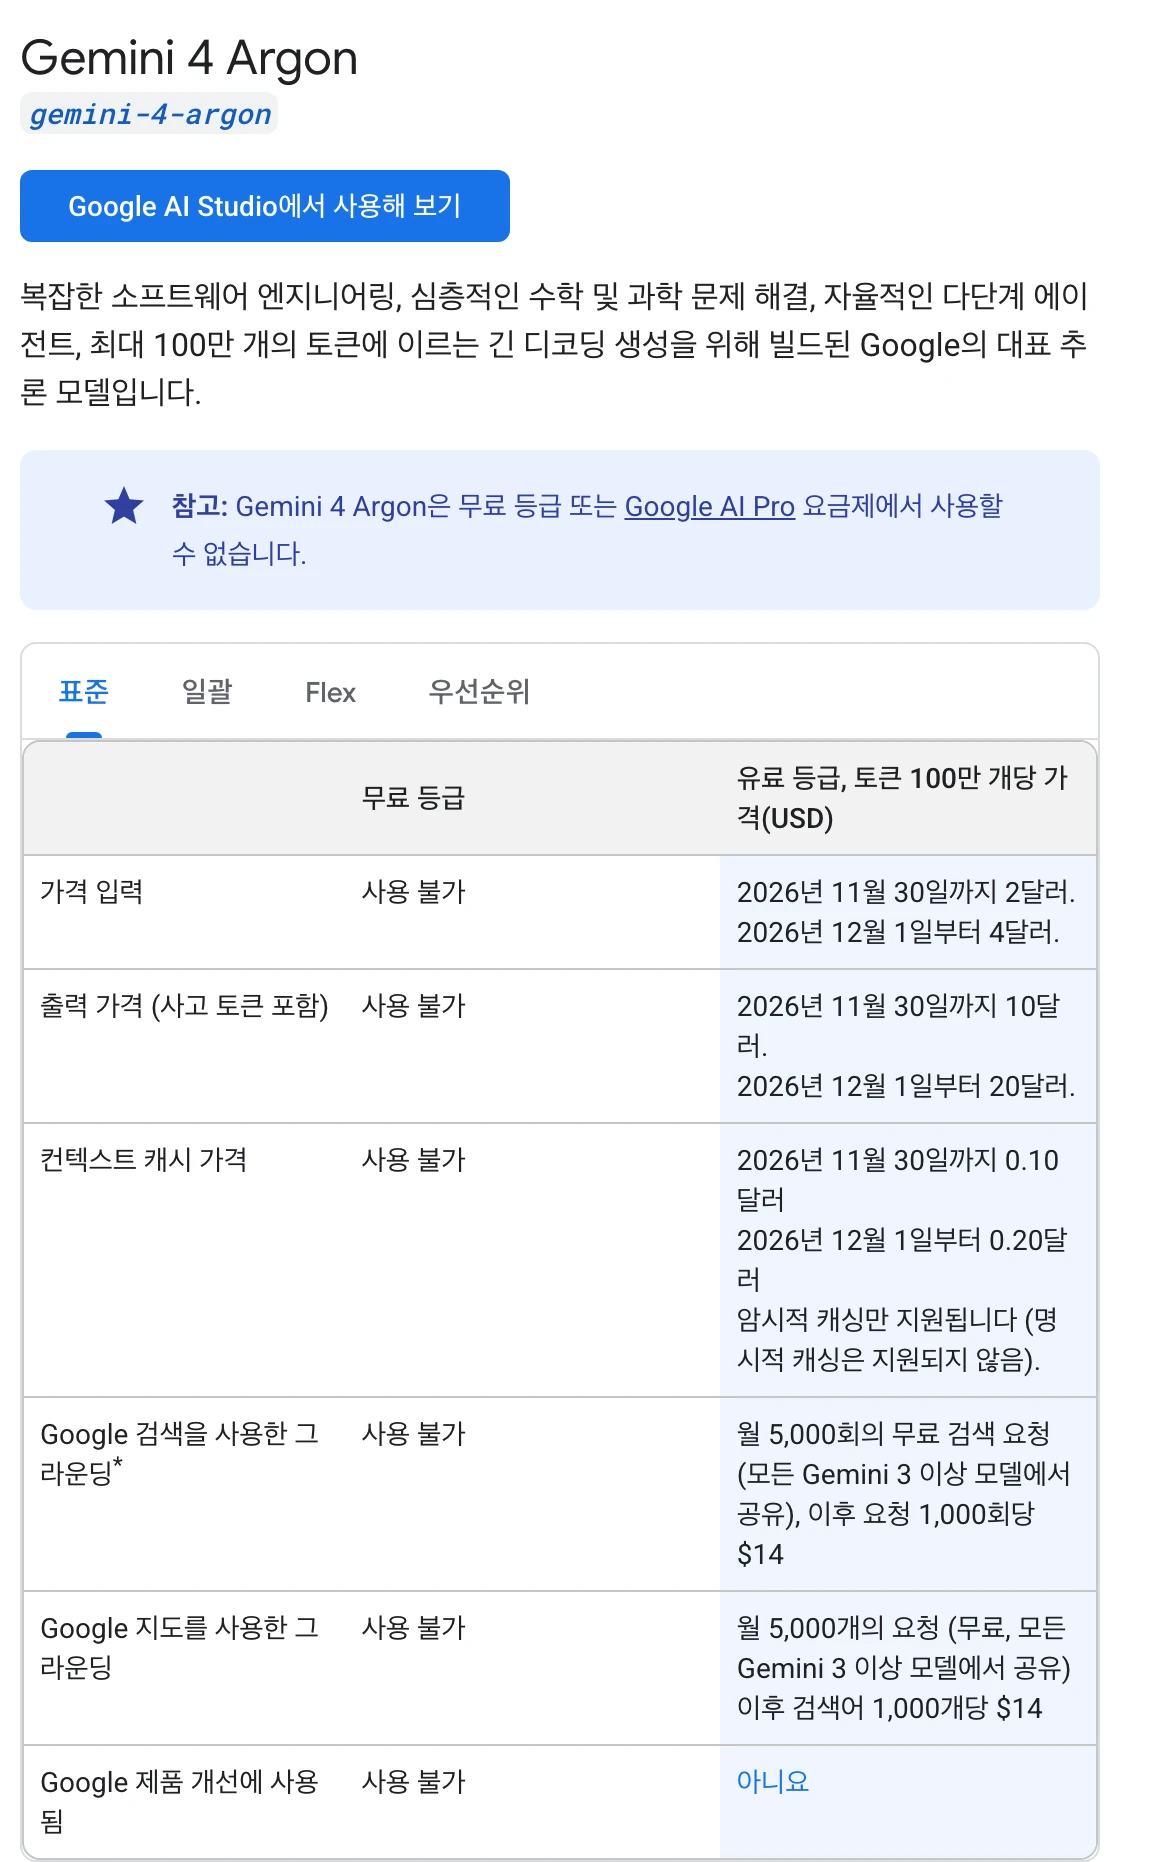
API도 구독과는 별개입니다. 가격 문서에 Argon은 무료 등급과 Google AI Pro 요금제에서는 쓸 수 없다고 적혀 있어서, 유료 티어를 따로 열어야 하거든요.
그러면 Pro가 Argon을 쓸 수 있는 곳은 Gemini 앱과 AI 모드입니다. 앱 공지에는 Pro·Ultra 구독자가 오늘부터 Argon에 접근하고 Tasks 기능도 쓸 수 있다고 나옵니다. 사용량은 Pro가 무료 버전의 4배이고, Ultra는 Pro의 5배(월 ₩119,000부터)와 20배(월 ₩300,000)입니다. Pro의 월 요금은 한국어 구독 안내 페이지에 나오지 않았는데, Ars Technica는 Pro 월 $20, Ultra 월 $99부터라고 전했습니다.
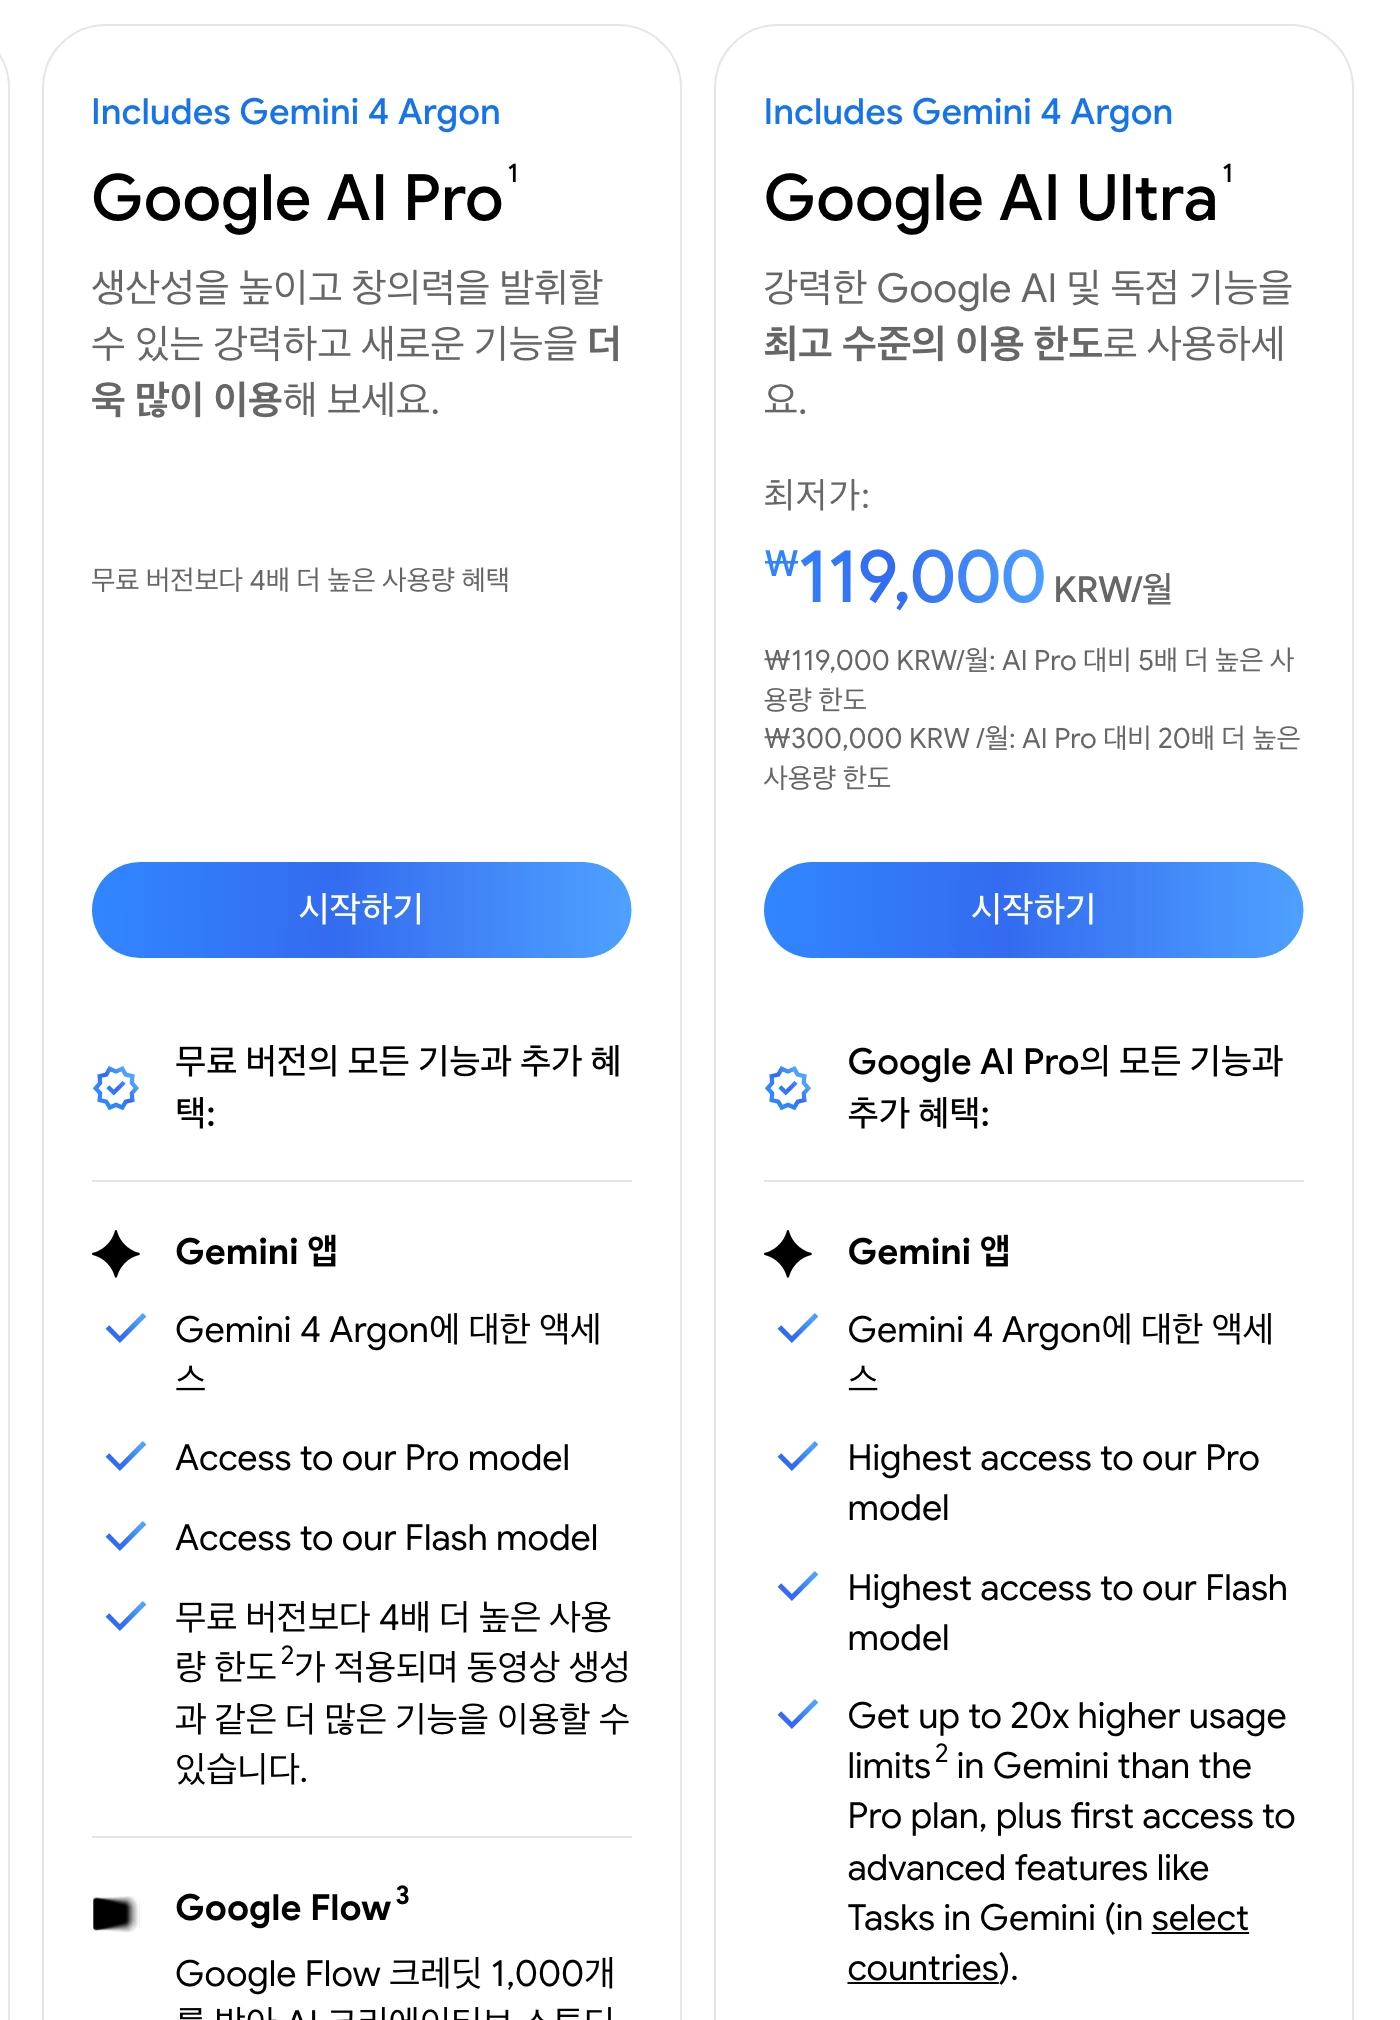
그 사이 Pro에 Antigravity나 AI Studio가 열린 건 아닌지도 다시 찾아봤는데, 10월 14일 오후 4시쯤까지 공식 글과 문서에서는 그런 안내를 못 찾았습니다. 오히려 Hacker News에는 Pro 계정으로 Antigravity를 열었다가 Ultra 전용이라는 안내를 봤다는 글이 여럿 있었고, Pro인데 앱에도 안 보인다거나 몇 시간 뒤에야 생겼다는 후기, EU 조직 계정과 영국 Pro 계정에서 안 보인다는 댓글도 나왔습니다. 공식 안내부터 "Pro와 Ultra에 열렸다"와 "Ultra 구독자만"으로 갈려 있으니 헷갈릴 만하죠. 내 모델 선택 화면을 직접 열어 보는 게 제일 정확합니다. 한국 계정은 한국어 요금제 소개 페이지에 '일부 국가' 제공이라는 문구가 있어서, 지금 바로 보이는지는 확인하지 못했습니다.
API 가격은 12월 1일에 두 배가 됩니다
API는 11월 30일까지가 도입가입니다. 입력 100만 토큰에 $2, 출력에 $10인데, 12월 1일부터 $4와 $20으로 두 배가 되고, 캐시된 입력도 $0.10에서 $0.20이 됩니다. 배치·Flex는 표준의 절반 값입니다. 구독료가 아니라 API 요금이라 Pro나 Ultra 요금제와는 상관이 없고, 경쟁 모델과 나란히 놓으면 이렇습니다.
| 모델(100만 토큰당) | 입력 / 출력 | 캐시 읽기 |
|---|---|---|
| Argon(~11/30) | $2 / $10 | $0.10 |
| Argon(12/1~) | $4 / $20 | $0.20 |
| GPT-6.1 Sol | $2 / $10 | $0.10 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 |
| Claude Opus 5.5 | $4 / $20 | $0.20 |
| GPT-6 Astra | $10 / $50 | $1.00 |
| Claude Fable 5.1 | $10 / $50 | $0.25 |
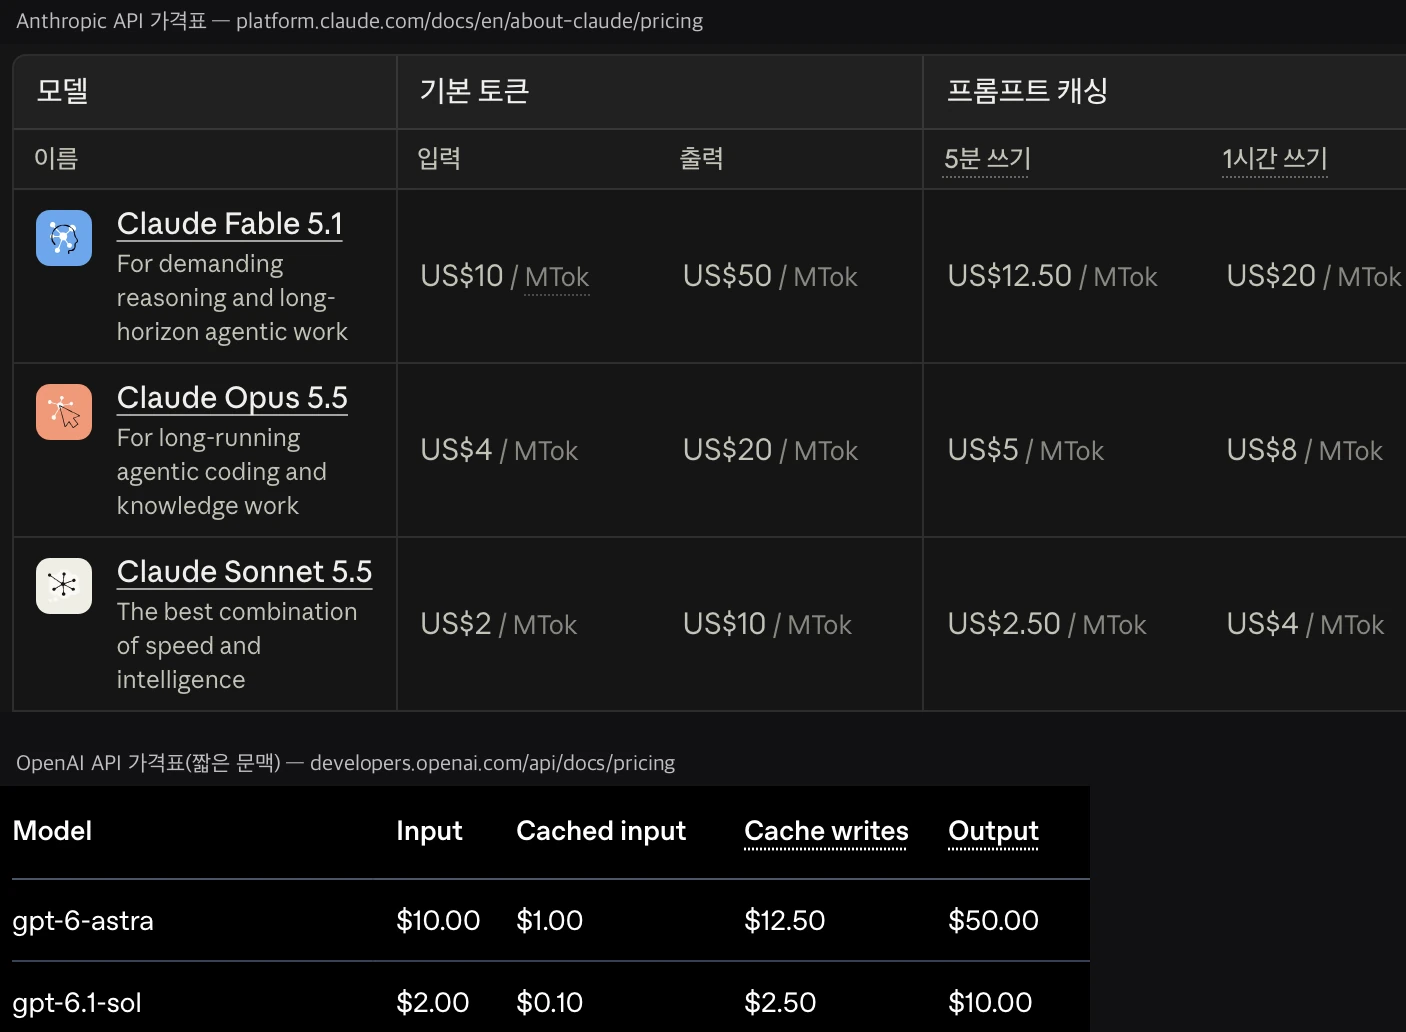
도입가의 Argon은 GPT-6.1 Sol·Claude Sonnet 5.5와 같은 값이고 Opus 5.5의 절반, Fable 5.1·Astra의 5분의 1입니다. 12월이 되면 Opus 5.5와 같은 값이 되고, Sol·Sonnet 5.5의 두 배가 되고요.
다만 단가가 곧 작업 비용은 아니죠. AA가 같은 평가 묶음을 돌릴 때 작업 하나에 드는 비용은 할인가 기준 Argon이 $1.99로 Astra($3.26)보다 낮습니다. 그런데 토큰을 덜 써서가 아니라 단가가 낮아서거든요. 작업당 출력 토큰이 Argon은 약 62k, Astra는 약 27k로 두 배가 넘습니다. 그래서 12월에 단가가 두 배가 되면 작업당 비용은 $3.98로 올라 Astra보다 약 1.2배 비싸집니다.
성적은 이긴 곳과 진 곳이 갈립니다
Google이 발표 글 앞에 내세운 숫자는 DeepSWE v1.1의 77.9%, LVBench의 91.7%, 그리고 Vals Index 1위입니다. 성적표에는 모두 19줄이 있는데, Google이 고른 비교 모델 셋과 견줘 Argon이 13줄에서 앞서고 1줄은 같고 5줄에서는 뒤처집니다. 아래 표에서 ▲는 Argon이 앞선 곳, ▼는 뒤진 곳이고, 뒤진 5줄 중 3줄만 골랐습니다.
| Google 표 | Argon | 비교 3종 중 최고 |
|---|---|---|
| DeepSWE v1.1 | 77.9 ▲ | 74.2 (Opus 5.5) |
| Harvey 법률 에이전트 | 19.6 ▲ | 6.7 (Fable 5.1) |
| GraphWalks 256k~1M | 84.2 ▲ | 71.8 (Astra) |
| LVBench | 91.7 ▲ | 87.5 (Astra) |
| FrontierSWE v2 | 55.0 ▼ | 65.5 (Astra) |
| Terminal-Bench 4.0 | 57.4 ▼ | 66.4 (Opus 5.5) |
| Terminal-Bench Science 0.1 | 57.6 ▼ | 68.1 (Astra) |
격차가 큰 곳은 법률 에이전트(Harvey)와 긴 문맥이고, 뒤진 곳은 터미널·에이전트형 코딩이 많습니다. 간판인 DeepSWE도 3.7점 차이로 앞서는 정도인 데다, 이 점수는 Google이 직접 계산한 값이에요(평가 방법 문서에 self computed라고 적혀 있습니다).
그럼 Google 밖에서 잰 결과는 어떨까요. AA에서는 Opus 5.5가 58점, Sonnet 5.5가 56점으로 앞서고 Argon은 53점이라 Fable 5.1·Astra와 비슷한 수준입니다. Vals AI의 Vals Index에서는 Argon이 68.90%로 1위인데, Sonnet 5.5(67.04%)와 Opus 5.5(66.97%)가 2점도 안 되는 차이로 따라옵니다. 이 지수는 금융 비중이 가장 크고 코딩이 그다음이에요.
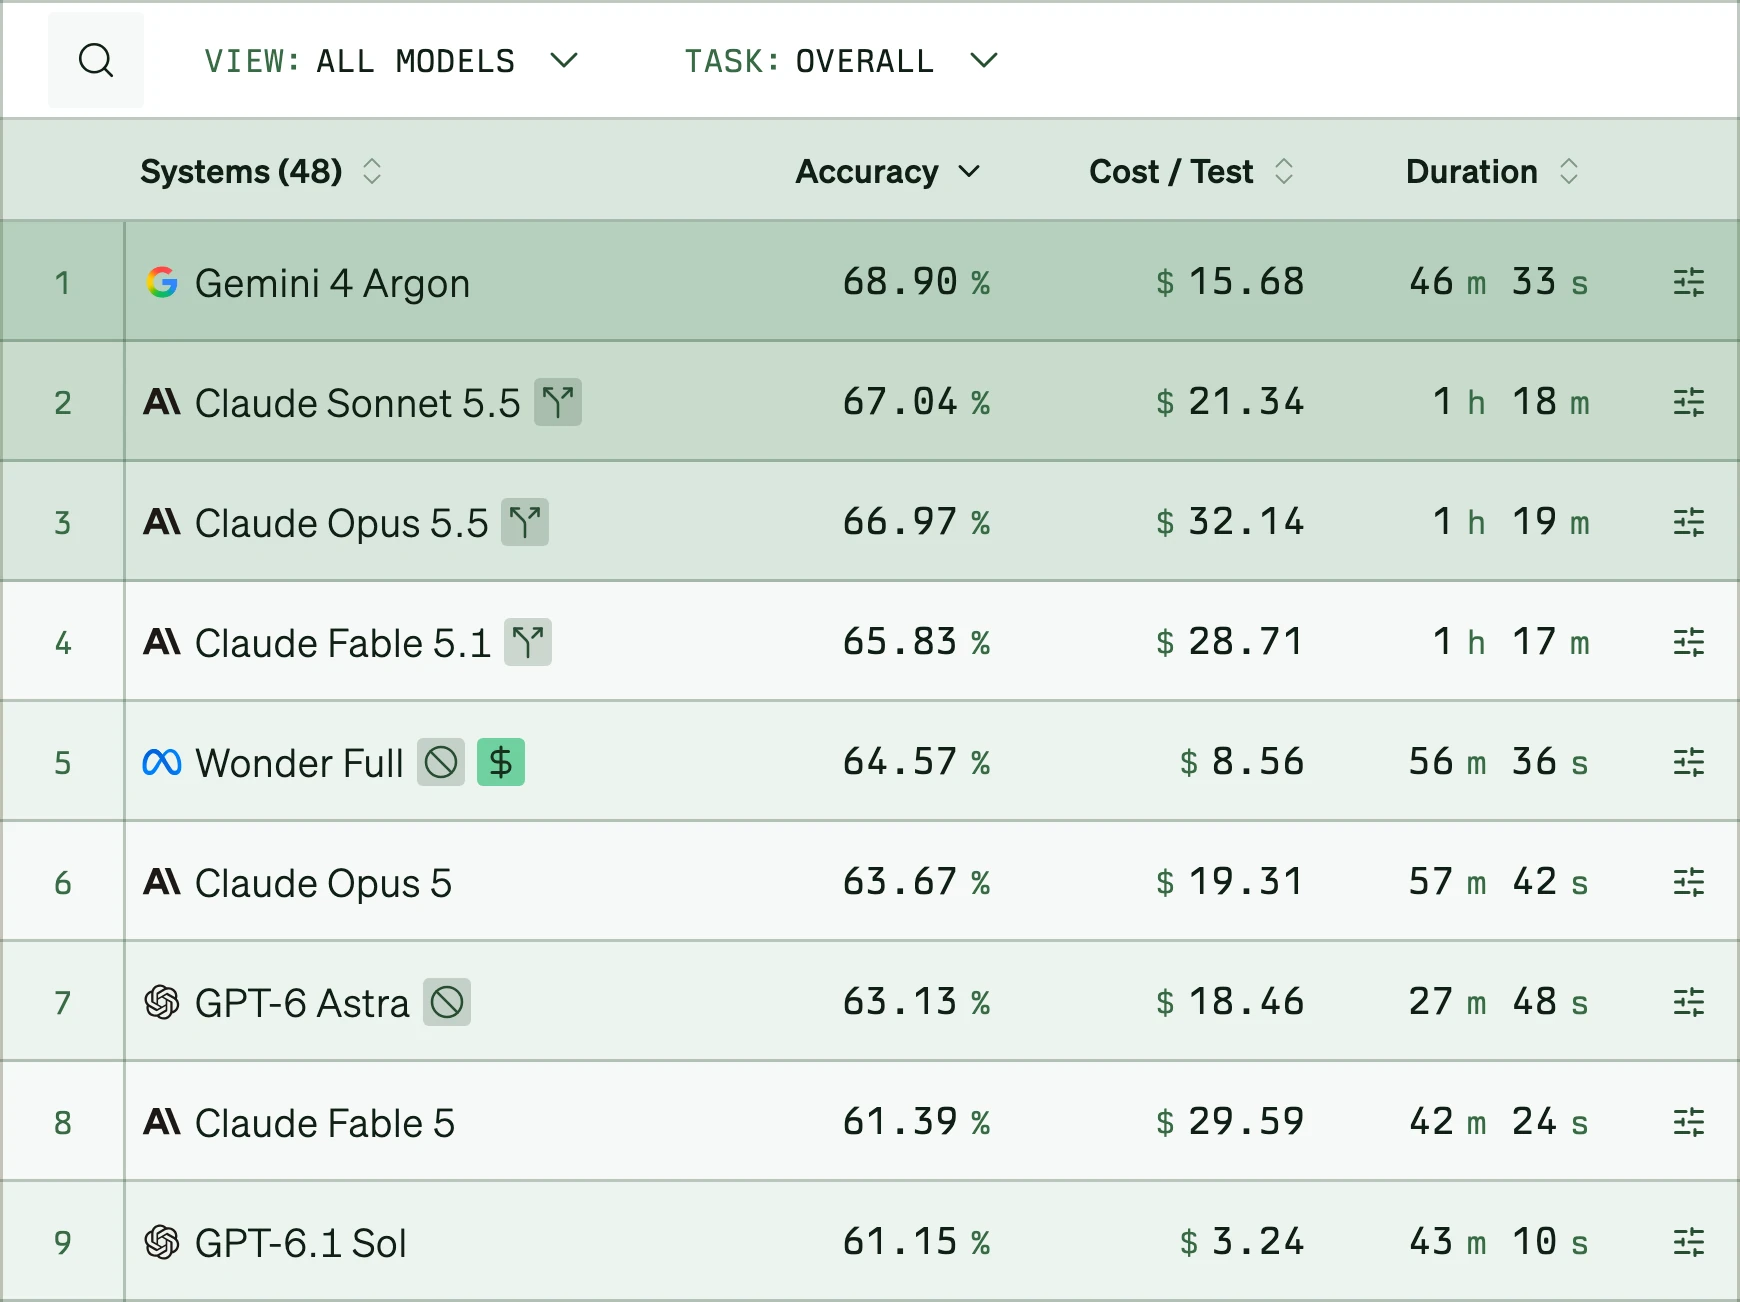
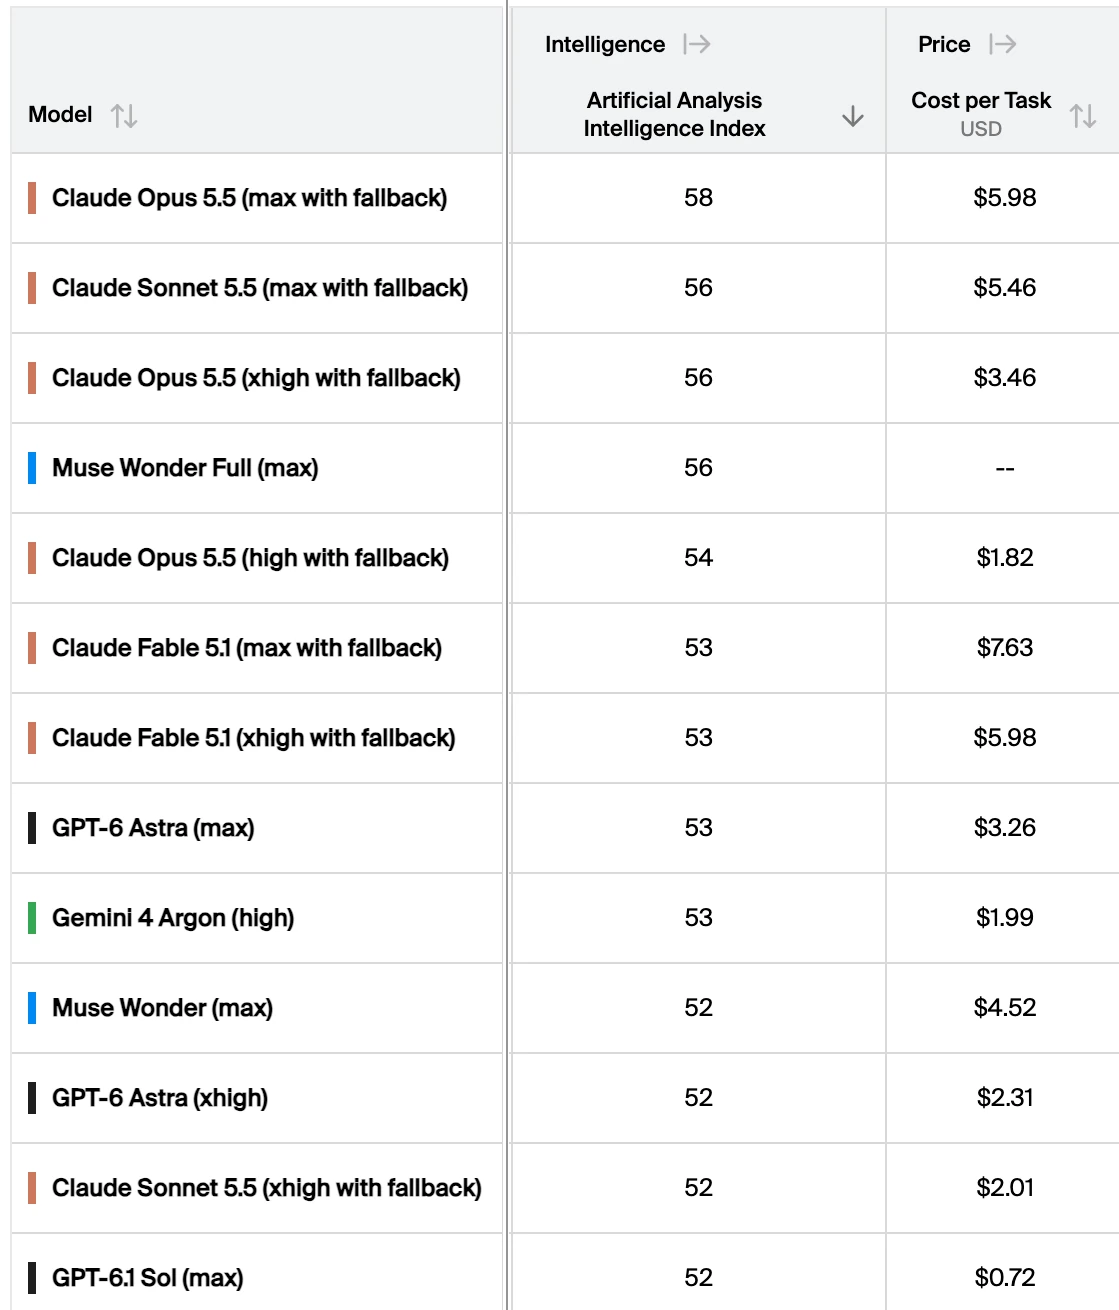
| 모델 | AA 지수 / 작업당 비용 | Vals 지수 / 테스트당 비용 |
|---|---|---|
| Argon | 53 / $1.99* | 68.90% / $15.68 |
| Claude Opus 5.5 | 58 / $5.98 | 66.97% / $32.14 |
| Claude Sonnet 5.5 | 56 / $5.46 | 67.04% / $21.34 |
| Claude Fable 5.1 | 53 / $7.63 | 65.83% / $28.71 |
| GPT-6 Astra | 53 / $3.26 | 63.13% / $18.46 |
| GPT-6.1 Sol | 52 / $0.72 | 61.15% / $3.24 |
AA 값은 Argon이 high 설정, 나머지가 max 설정이고 Claude 모델에는 fallback이 붙어 있습니다. Argon 비용(*)은 할인가 기준이라 12월 이후에는 $3.98이고, 두 사이트의 평가 구성이 달라서 점수끼리 직접 견줄 수는 없습니다.
발표에서 눈에 띄던 '환각률 15%'는 Google이 낸 숫자가 아니라 AA의 지식 평가에서 나온 값입니다. Astra 51%, Sol 54%보다 훨씬 낮고, AA도 종합 점수 45점 이상인 모델 중 가장 낮다고 소개했죠. 다만 같은 평가에서 정확도는 50%로 Astra의 63%보다 13점 낮습니다. 모르면 지어내기보다 모른다고 하는 경향이 강하다는 뜻이라, 틀린 답을 덜 내놓는 대신 맞히는 답도 적은 거예요. 환각률 한 줄만 읽으면 인상이 달라지는 이유입니다. Claude 모델의 환각률은 값을 못 찾아서 비교하지 않았습니다.
그래서 Argon을 쓸 이유가 있을까요
작업별로 앞선 쪽을 정리하면 이렇습니다.
| 맡길 일 | 앞선 쪽 |
|---|---|
| 금융 업무 | Argon(Vals Finance Agent v2). 엑셀·세무는 Fable 5.1 |
| 긴 문맥 탐색 | Argon(GraphWalks, Google 자체 측정) |
| 터미널 코딩 | Claude Opus 5.5·Sonnet 5.5(Terminal-Bench 세 곳) |
| DeepSWE형 작업 | Argon(Google 자체 측정) |
| 환각 줄이기 | Argon(AA: 45점 이상 모델 중 환각률 최저, 정확도는 낮음) |
| 작업 비용 | GPT-6.1 Sol(AA $0.72, Vals $3.24) |
숫자로 Argon이 나은 곳은 세 군데입니다. 첫째는 비용 대비 성능인데, Vals에서는 Claude 세 모델보다 싸고 빨랐고(테스트당 $15.68에 46분, Claude는 $21~32에 1시간 17분 안팎) AA에서는 점수가 같은 Astra·Fable 5.1보다 작업당 비용이 낮았습니다(할인가 기준). 둘째는 금융 업무 에이전트(Vals의 Finance Agent v2 1위)와 긴 문맥 탐색(GraphWalks, Google 측정)이고, 셋째는 이미 Pro를 구독 중이라면 Gemini 앱에서 구독료 외 추가 비용 없이 써 볼 수 있다는 점입니다. 사용량 한도는 있고요.
반대로 코딩 에이전트가 중심이라면 항목마다 엇갈립니다. DeepSWE는 Argon이 앞서지만 Terminal-Bench는 Google 표, Vals, AA 세 곳 모두 Argon이 1위가 아니었고, AA 종합 점수도 Opus 5.5와 Sonnet 5.5가 위입니다. 값을 같은 선에 놓아도 Opus 5.5(high)는 54점에 작업당 $1.82라서, 할인가 Argon(53점, $1.99)보다 점수는 높고 값은 비슷하네요. 12월 정가의 Argon($3.98)은 Opus 5.5(xhigh, 56점, $3.46)보다 점수도 비용도 불리하고요. 값싼 쪽이 목적이면 비교한 모델 중에는 AA 기준 작업당 $0.72인 GPT-6.1 Sol이 가장 쌉니다. 법률도 Google 표의 Harvey에서는 앞서지만 Vals의 법률 항목에서는 다른 모델이 1위였습니다.
그래서 이미 Claude나 ChatGPT를 쓰고 있다면 당장 갈아탈 이유까지는 없어 보이고, Pro라면 앱에서 한번 시험해 볼 만한 정도로 읽힙니다. 직접 비교한 제3자 결과가 더 쌓이기 전이라, 이 정리도 지금 시점의 것이에요.
써 본 사람들은 뭐라고 했나
Hacker News 스레드는 10월 14일 오후 4시쯤 1,213점, 댓글 850개였습니다. 접근 불만이 많았고, Google의 롤아웃이 프런티어 랩 가운데 최악이라는 댓글에는 그래도 일반인은 여전히 Google을 쓴다는 말이 같이 붙어 있었죠.
성능 쪽에서는 글쓰기 호평이 눈에 띄었습니다. API로 먼저 써 본 사용자는 답이 또렷하고 문체가 뚜렷하다면서도 줄표(—)가 다시 늘었다고 덧붙였고, 평소 Claude에 하던 질문을 넣어 본 다른 사용자는 답이 에세이처럼 정리돼 나온다며 코딩이 아닌 용도는 앞으로 이쪽을 쓰겠다고 했습니다. 코딩은 엇갈렸는데요. 이미지를 HTML로 옮기는 시험에서 B 등급이라 Opus 5.5나 Astra에는 못 미친다는 평이 있었고, 3.8 Flash가 껍데기만 만들고 끝낸 리팩터링을 Argon이 검토해서 문제를 짚어냈다는 글도 있었습니다.
비용 시험도 하나 올라왔습니다. 한 사용자가 자기 프로젝트의 작은 버그 11건을 시켰더니 Argon은 10건을 풀었는데, 한 번 돌릴 때 중앙값 비용이 $0.52로 Sonnet 5.5($0.18)와 Sol($0.09)보다 비쌌다고 합니다. 출력 토큰이 약 24k로 Sonnet의 약 3k보다 훨씬 많았다는 점은 AA 수치와 같은 방향인데, Sonnet보다 비쌌다는 건 AA·Vals에서 Argon이 더 쌌던 것과는 반대네요.
확인된 것과 아직 모르는 것
확인된 건 비교적 단순합니다. 유료로 열렸고, Pro 구독자는 Gemini 앱과 AI 모드까지, Antigravity와 AI Studio는 Ultra, API는 구독과 별개의 유료 티어이며 API 가격은 12월 1일에 두 배가 됩니다. 성능은 Google 표와 독립 평가 두 곳 모두에서 Terminal-Bench 같은 터미널 코딩은 Argon이 앞서지 못했고, 금융·코딩 비중이 큰 Vals Index에서는 1위지만 차이가 작습니다.
아직 모르는 건 이렇습니다.
- Pro 구독자에게 Antigravity나 AI Studio가 열릴지, 한국 계정에서 지금 보이는지, Pro의 한국 월 요금
- Google이 직접 계산한 숫자를 제3자가 같은 조건으로 재현했는지
- Claude 모델들의 환각률